
仿真数据驱动的卫星时序预测 AI 方案
01
项目背景
真实运行中的异常和退化样本往往少于正常样本,部分故障也不适合在设备上主动制造。方案采用参数化仿真补充候选工况,服务健康趋势、异常识别和专项预测研究。
仿真样本的覆盖范围受模型、参数和故障机制限制。每组数据需记录输入、求解配置、随机种子和有效性检查,避免把数值失败或不合理工况当成训练真值。
02
技术路线
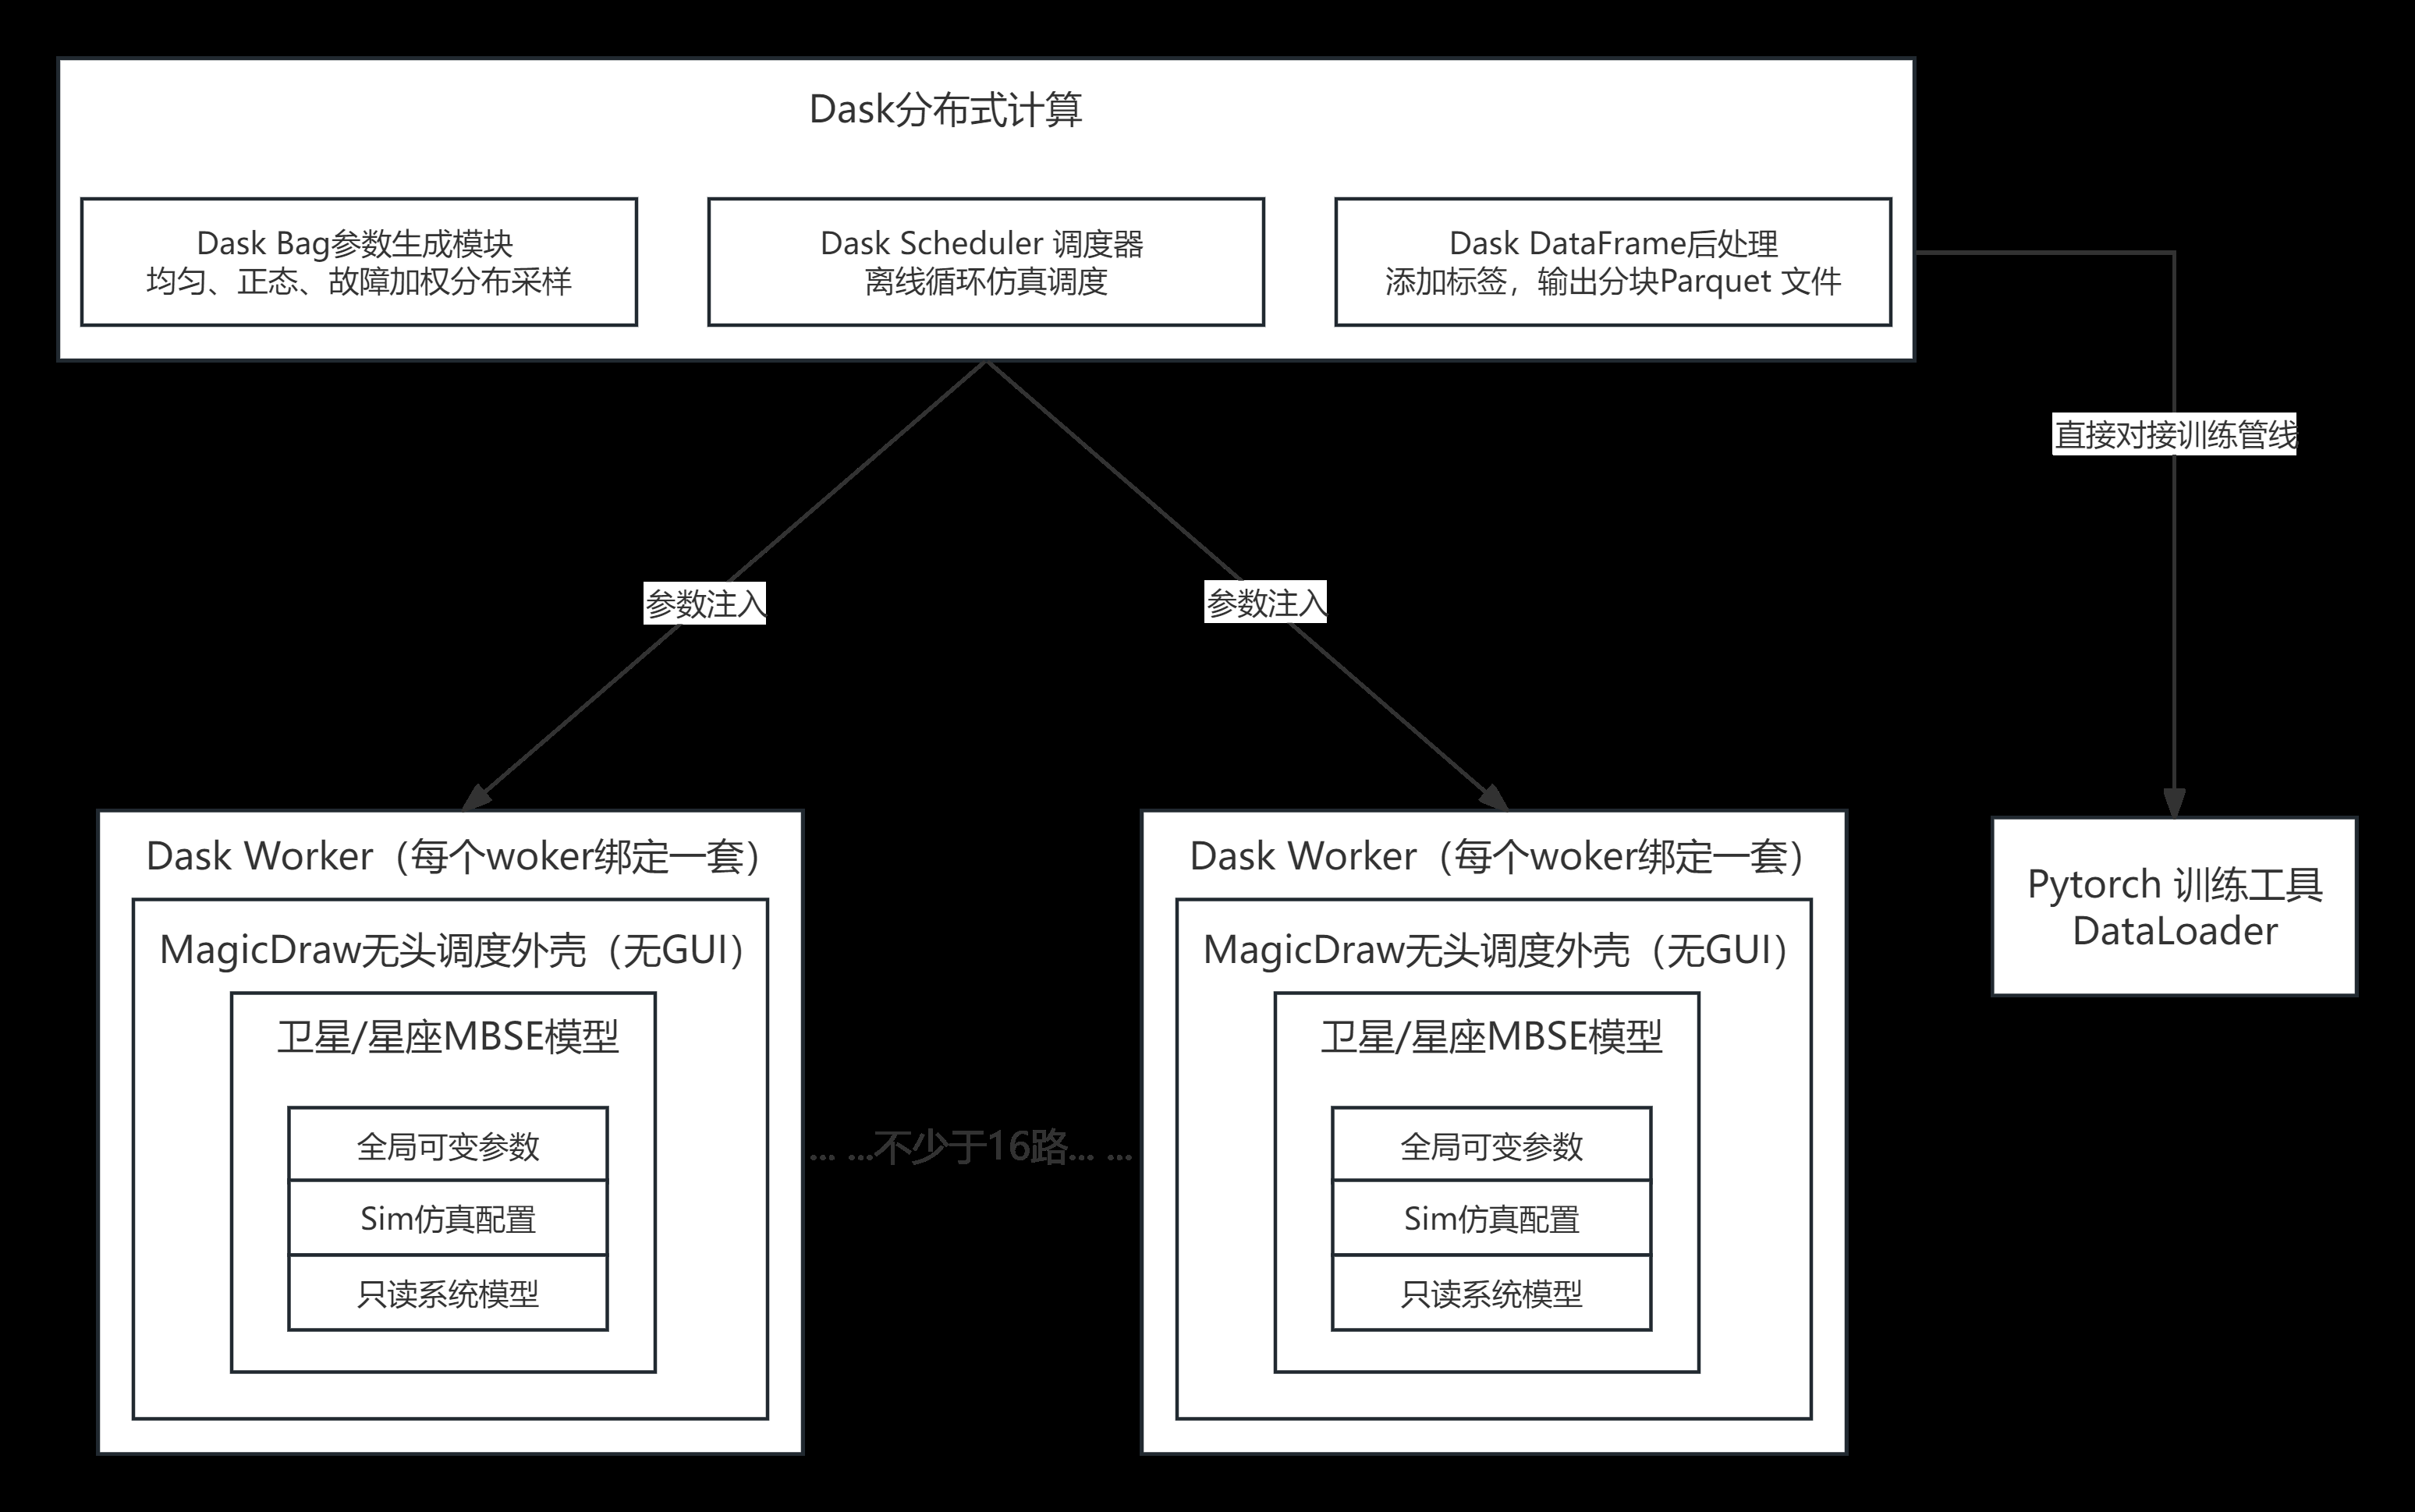
可研提出以分布式任务调度管理多个仿真实例,将参数扫描、故障注入、结果检查与数据集登记组成流水线。调度服务与仿真工具许可、并发资源和失败重跑策略需共同评估。
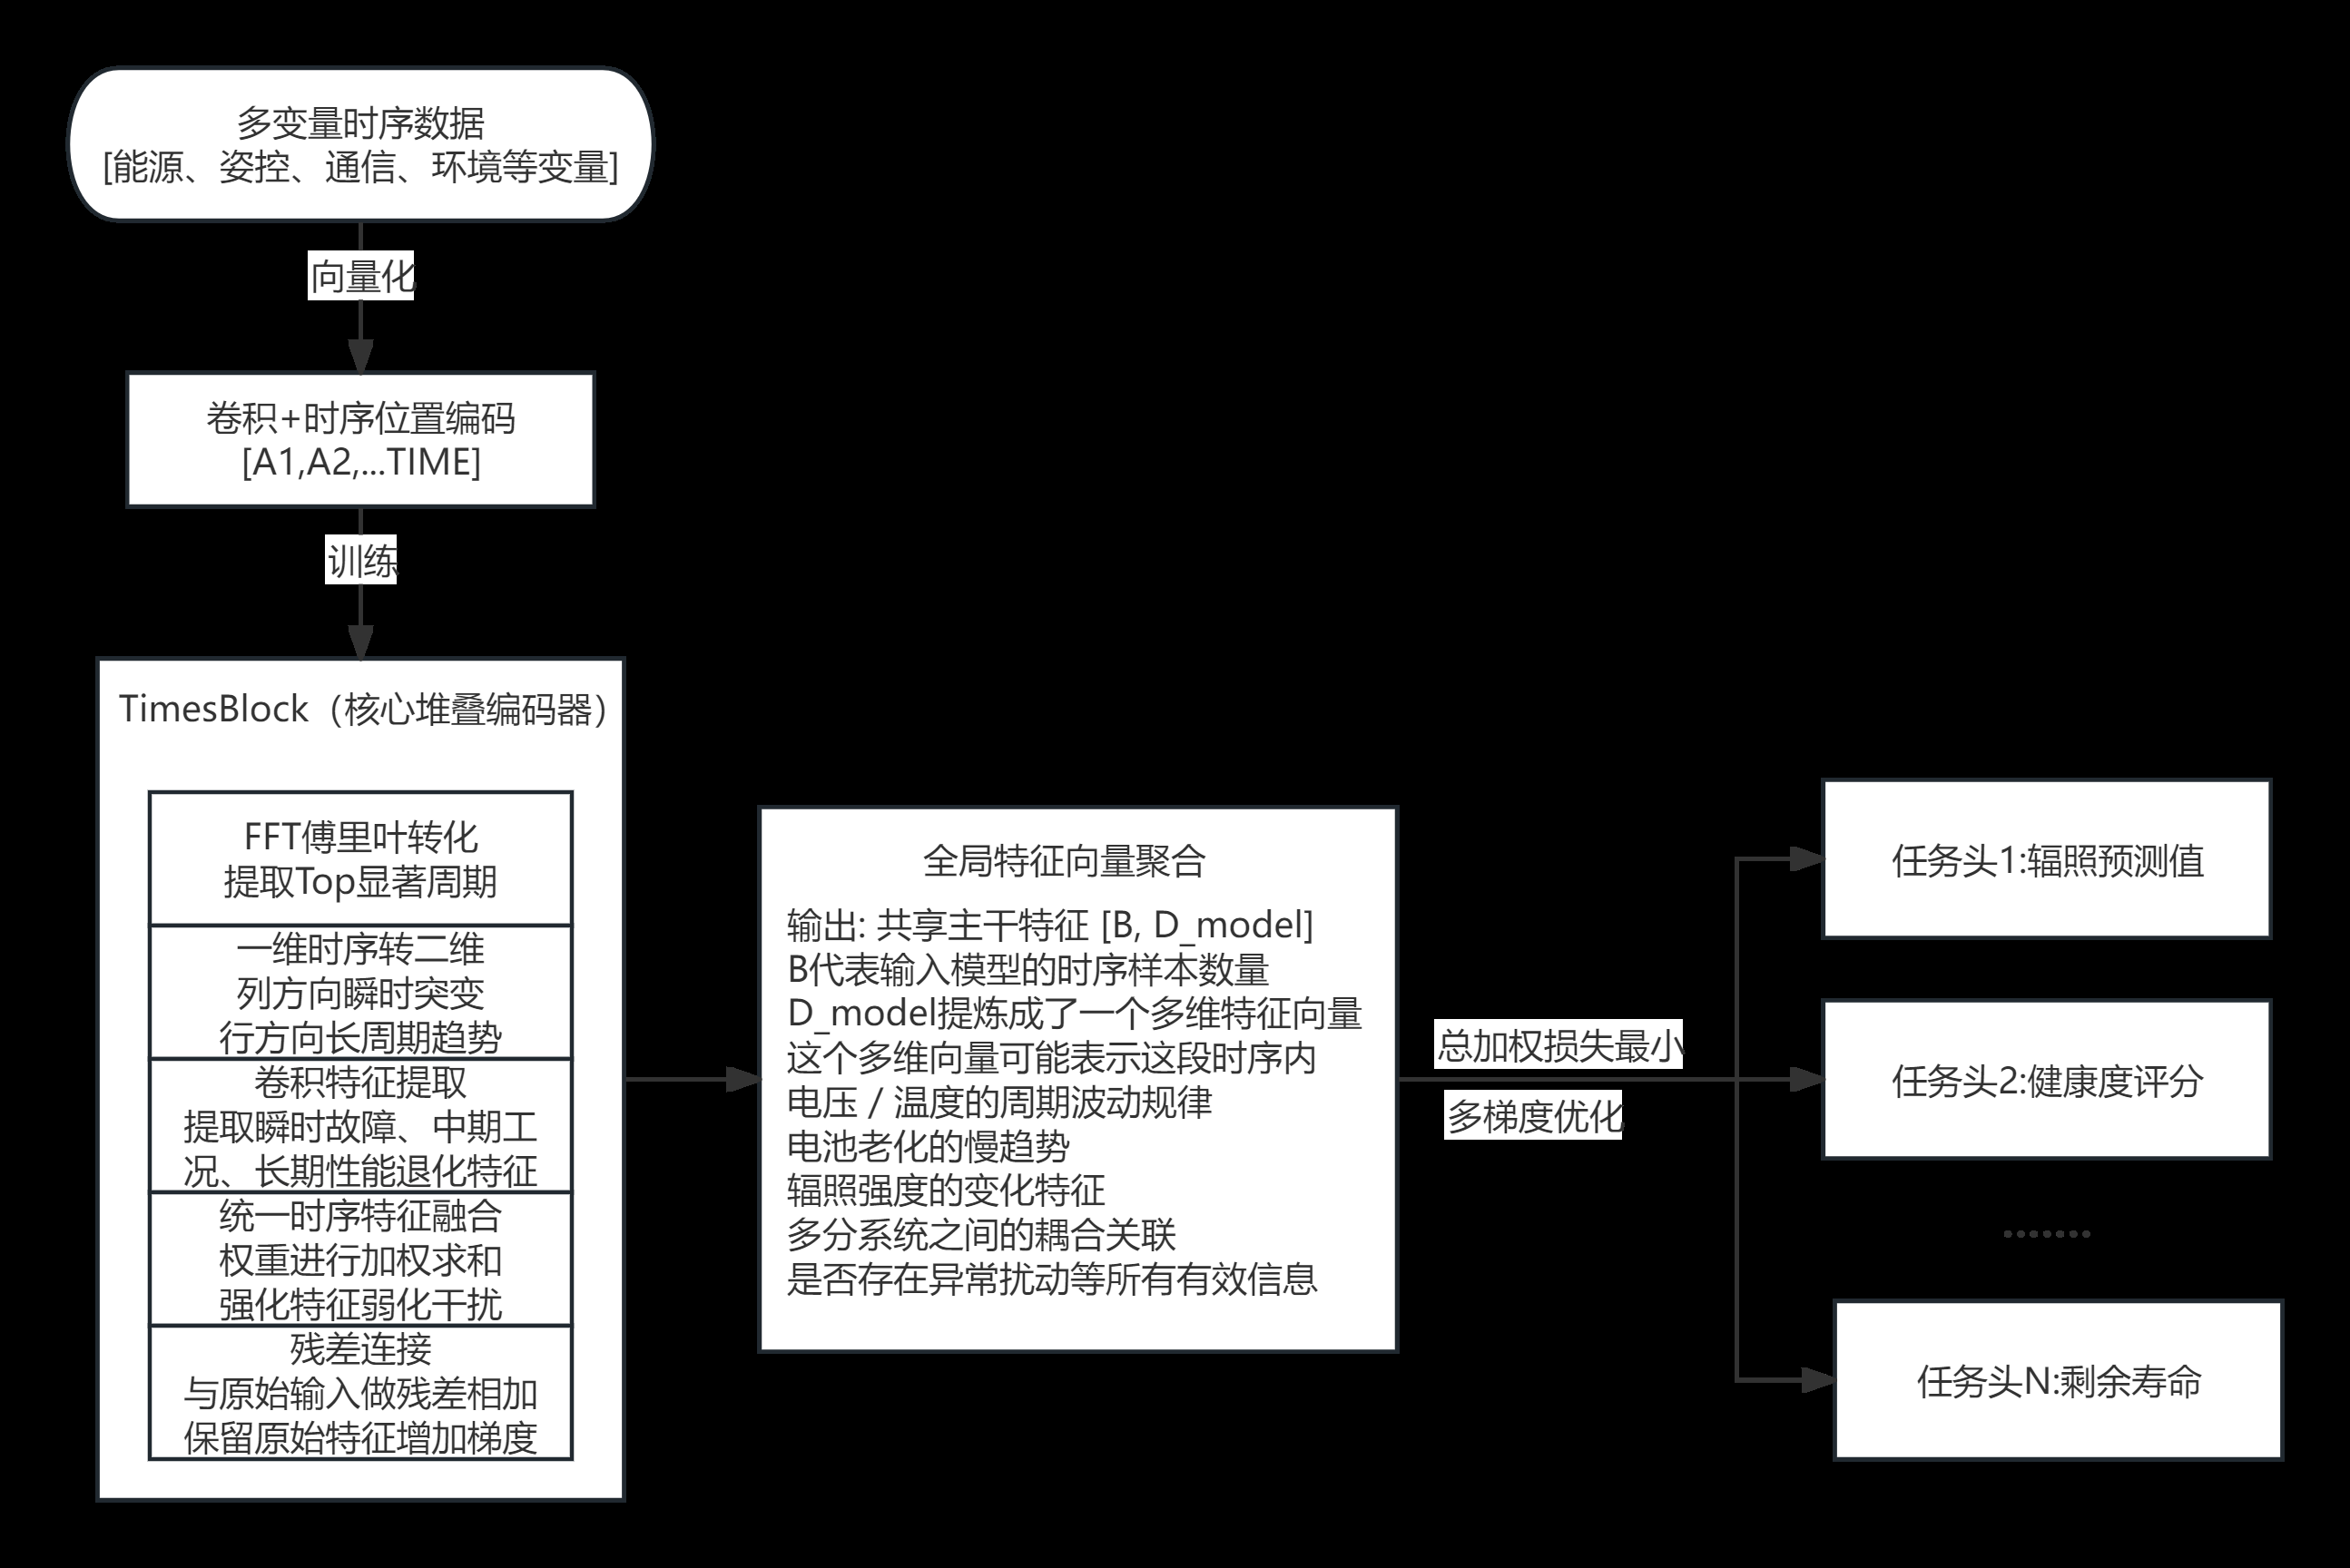
训练路线采用仿真预训练与真实数据微调,参考 TimesNet 等时序建模方法。可按分系统设置独立模型或共享主干的任务头;是否共享取决于任务相关性,并通过独立验证集比较。
03
实施路径
先在单个子系统上完成小批量数据生成和可重复训练,再增加并发任务与工况种类。按设备、任务或时间段隔离训练与评测数据,避免相邻时间窗泄漏造成过高的评估结果。
推理后检查量纲、工作区间和适用的守恒或变化趋势约束。边缘部署先测延迟、内存、功耗和误差,再决定是否压缩或蒸馏,不能仅凭参数数量判断能够上星。
04
交付范围
拟交付工况矩阵、故障注入说明、数据版本与质量记录、生成任务配置、训练配置和评测报告模板。模型权重、推理包与部署报告在训练及目标硬件验证完成后按范围交付。
05
验收方法
分别测量生成任务完成率、无效样本比例、单位资源产出与数据追溯完整性。预测任务检查误差与区间覆盖,异常任务检查误报和漏报,并将不同工况及真实数据结果单列。
方案中的样本规模、并发数量、压缩比例和生成周期属于待验证规划参数。需要用实际许可环境、代表工况和硬件完成基准试验,再确定生产计划。
06
实施效果
架构设计覆盖数据生成、训练流程与工程约束。下一阶段先打通分布式数据生成,再验证样本质量、训练复现性与独立测试集上的预测表现。
后续试点以可复现的小规模数据集和独立真实数据评测为起点,逐步确认仿真可信范围、任务泛化能力和资源成本,再扩展训练与部署。